Synthetische Stimme · KI-generiert (Text-to-Speech).
Am 31. Juli 2026 hat die 42. Zivilkammer des Landgerichts München I dem US-Anbieter Suno untersagt, geschützte Musikwerke zu vervielfältigen — ausdrücklich einschließlich der Nutzung als Trainingsmaterial. Die GEMA setzte sich weitgehend durch: Unterlassung, Auskunft, Schadensersatz. Es ging unter anderem um Titel wie „Forever Young“ und „Atemlos“.
Berichtet wurde das als Sieg der Musikbranche. Interessanter ist die Begründung: Die Speicherung geschützter Werke im Modell ist eine Vervielfältigung nach § 16 UrhG, und die Schranke für Text und Data Mining in § 44b UrhG deckt das nicht. Das betrifft jedes Unternehmen, das generative KI einsetzt, und wirft zwei Fragen auf, die in Beschaffungsprozessen nie gestellt werden: Woraus wurde mein Werkzeug trainiert — und wem gehört, was es ausgibt?
Auf einen Blick
- Was entschieden ist: LG München I, 42. Zivilkammer, 31.07.2026 — Training ohne Lizenz ist Vervielfältigung (§ 16 UrhG), § 44b UrhG greift nicht.
- Was folgt: Europäische Gerichte sind auch bei Training in den USA zuständig, wenn das System in Europa läuft. Das Lizenzrisiko wandert die Lieferkette hinab, bis zu dem, der die Ausgabe verwendet.
- Der Haken: Nicht rechtskräftig, vollstreckbar nur gegen Sicherheitsleistung; das Parallelverfahren GEMA gegen OpenAI liegt beim OLG München in der Berufung.
Was das Gericht entschieden hat
Der Kern ist die Memorisierung. Die GEMA hat nicht bloß behauptet, dass Werke im Training steckten, sondern gezeigt, dass der Generator Songs ausgab, die den Originalen stark ähnelten. Daraus hat die Kammer geschlossen, dass die Werke im Modell gespeichert sind, und in dieser Speicherung auf Servern in Deutschland eine Verletzung des Vervielfältigungsrechts gesehen. Angegriffen wird nicht die Analyse, sondern was danach im Modell übrig bleibt.
Damit war auch § 44b UrhG erledigt. Die Vorschrift erlaubt Text und Data Mining und die dafür nötigen Vervielfältigungen — die aber zu löschen sind, sobald die Analyse sie nicht mehr braucht. Ein Modell, das Werke dauerhaft wiedererkennbar speichert, hat die Analyse hinter sich gelassen; dort endet die Schranke nach Auffassung der Kammer. Es ist das zweite Münchner Urteil dieser Art:
| GEMA gegen Suno | GEMA gegen OpenAI | |
|---|---|---|
| Gericht | LG München I, 42. Zivilkammer | LG München I; Berufung: OLG München |
| Datum | 31.07.2026 | 11.11.2025, Berufung 08.12.2025 |
| Gegenstand | Musikwerke | neun Songtexte |
| Kern | Memorisierung ist Vervielfältigung, § 44b UrhG greift nicht | Verletzung bei Training und Betrieb |
| Stand | nicht rechtskräftig | nicht rechtskräftig, anhängig (OLG München, 6 U 3662/25 e) |
Zwei Kammern, zwei Beklagte, dieselbe Richtung. Das ist die belastbare Aussage — und ausdrücklich nicht die, die Rechtslage sei geklärt.
Drei Gründe, das Urteil nicht zu überdehnen
Erstens: eine Kammer, eine Instanz, ein Verfahren. Das OLG München kann die Berufung anders entscheiden, und weder BGH noch EuGH haben sich zur Reichweite von § 44b UrhG beim Modelltraining geäußert. Wer Ihnen heute sagt, wie das ausgeht, spekuliert — auch wenn er in dieselbe Richtung spekuliert wie zwei Münchner Kammern.
Zweitens: getragen hat das Verfahren die Ausgabe, nicht das Training. Untersagt wurde ausdrücklich auch die Nutzung als Trainingsmaterial, aber der Beweis kam von der anderen Seite des Modells — aus Ausgaben, die den Originalen hörbar ähnelten. Praktisch heißt das: Ihr belastbarster Indikator ist nicht die Trainingsdatenliste, sondern das, was das Werkzeug bei Ihnen produziert. Der zugesprochene Auskunftsanspruch zeigt, dass die Gerichte die Beweisnot der Rechteinhaber sehen.
Drittens: Musik ist der empfindlichste Fall, nicht der typische. Ein Musikrepertoire ist rechtlich dicht organisiert — eine Verwertungsgesellschaft bündelt die Rechte, und Ähnlichkeit hört man. Bei Texten, Bildern und erst recht bei Code ist die Rechtekette diffuser und Ähnlichkeit schwerer zu greifen. Das ändert die Rechtslage nicht, wohl aber die Beweislage.
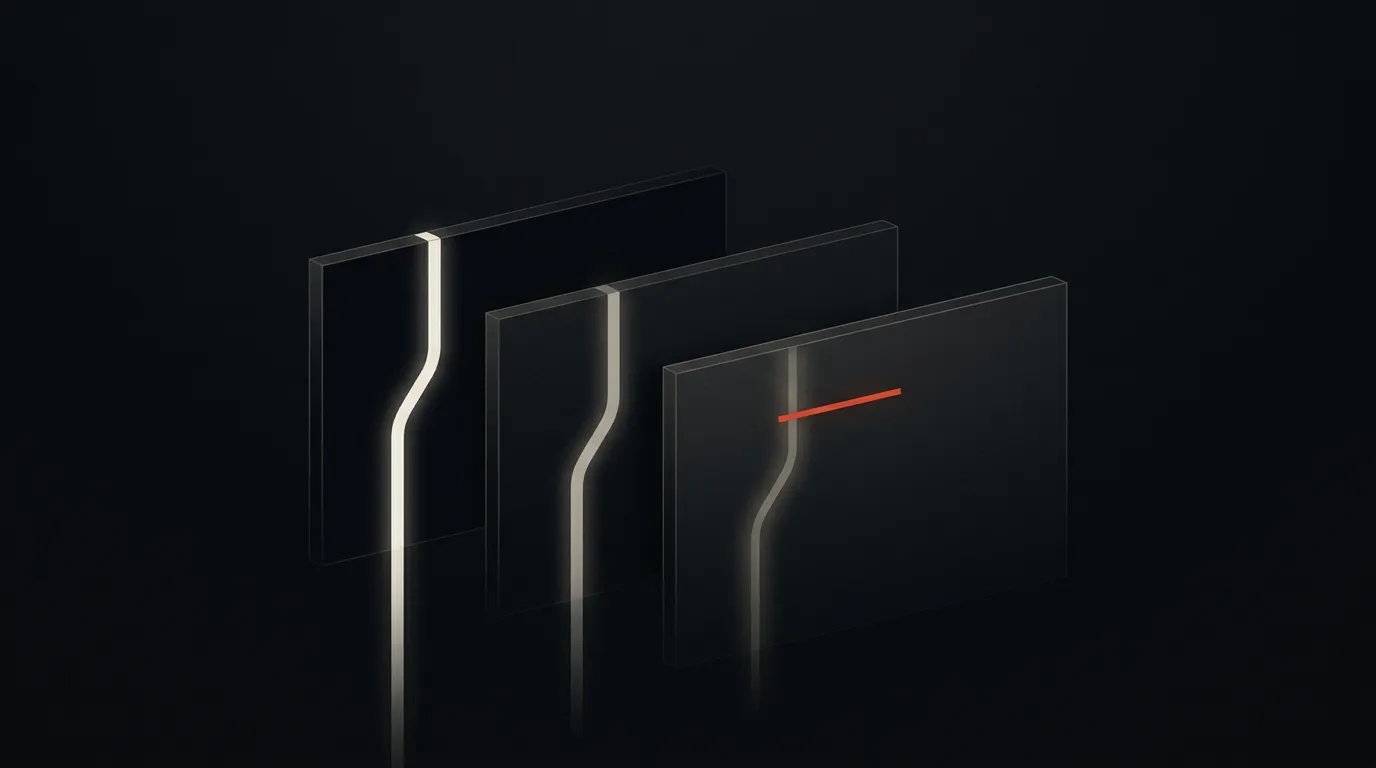
Dieselbe Form, dreimal durchgereicht: aus dem Trainingsmaterial in das Modell, in die Ausgabe, in Ihre Unterlagen. Die Markierung sitzt auf der letzten Wiederholung — dort, wo das Lizenzrisiko ankommt.
Was das für Ihr Unternehmen heißt
Fragen Sie nach der Herkunft — und dokumentieren Sie die Antwort. Eine vollständige Trainingsdatenliste bekommen Sie nicht und brauchen sie nicht. Brauchbar ist, was der Anbieter schriftlich zusagt: dass Trainingsdaten lizenziert sind, dass maschinenlesbare Nutzungsvorbehalte respektiert werden, dass Ausgaben nicht auf memorisierte Werke zurückfallen. Ein „dazu äußern wir uns nicht“ ist auch ein Ergebnis und gehört ins Risikoregister — in dem Schatten-KI nie auftaucht, weil niemand sie kennt.
Verhandeln Sie Freistellung, nicht Beteuerung. Die wichtigste Klausel ist keine Zusicherung über Trainingsdaten, sondern die Freistellung: Wer trägt Abwehrkosten und Schadensersatz, wenn ein Dritter wegen einer Ausgabe Ansprüche erhebt? Prüfen Sie Deckelung, Ausnahmen und Verfahrensherrschaft — eine Freistellung, die auf die Jahresvergütung begrenzt ist, trägt nicht. Die fünf Punkte im Zusammenhang: KI-Verträge, was wirklich rein muss.
Sichern Sie Ihre Ausgaben in beide Richtungen. Nach außen: eine Prüfung dort, wo Wiedererkennbarkeit droht — Musik, Bildmotive, längere Textpassagen, Code aus bekannten Repositorien. Nach innen: reiner KI-Output ist meist nicht urheberrechtlich geschützt (§ 2 Abs. 2 UrhG); wer Ergebnisse exklusiv nutzen will, braucht vertragliche Nutzungsrechte und sollte den eigenen Gestaltungsanteil dokumentieren. Der AI Act hilft hier nicht: Seine Fristen betreffen Transparenz und Risikoklassen, nicht die Rechte am Trainingsmaterial.
Fazit
Das Urteil ist kein Wendepunkt, auf den man eine Strategie stellen kann — dafür ist die Instanz zu niedrig und das Verfahren zu offen. Es ist aber auch kein Branchenkuriosum, das man abwarten kann. Was sich verschiebt, ist die Verhandlungslage: Solange § 44b UrhG als Freibrief für kommerzielles Training galt, war die Frage nach der Trainingsherkunft aussichtslos. Jetzt ist sie berechtigt.
Für den Mittelstand folgt daraus wenig Panik und ein klarer Arbeitsauftrag: Die Rechtslage zum Training können Sie nicht beeinflussen, Ihre Werkzeugliste, Ihre Verträge und Ihre Ausgabenprüfung schon. Ob Ihre Verträge diese Lage tragen, sprechen wir gern durch. Ich lese sie als Wirtschaftsjurist und baue die Systeme, um die es dabei geht, selbst.
FAQ
Ist KI-Training mit geschützten Werken in Deutschland jetzt verboten?
So pauschal nicht. Eine Kammer eines Landgerichts hat in einem Verfahren entschieden, nicht rechtskräftig: Training ohne Lizenz ist Vervielfältigung nach § 16 UrhG, § 44b UrhG greift dafür nicht. Das Parallelverfahren gegen OpenAI liegt beim Oberlandesgericht München in der Berufung — belastbar ist eine Richtung, keine geklärte Rechtslage.
Haften wir, wenn wir ein KI-Werkzeug mit unklarer Trainingsherkunft einsetzen?
Die Unterlassung trifft zunächst den Anbieter, nicht den Nutzer. Das Risiko wandert aber weiter: Wer eine Ausgabe verwendet, die ein geschütztes Werk wiedererkennbar wiedergibt, vervielfältigt es im eigenen Betrieb. Wichtiger als die Trainingsdatenliste sind deshalb eine belastbare Freistellungsklausel und eine Ausgabenprüfung dort, wo Wiedererkennbarkeit droht.
Was regelt § 44b UrhG und warum hat er hier nicht getragen?
§ 44b UrhG erlaubt Text und Data Mining, also die automatisierte Analyse digitaler Werke; die dafür nötigen Vervielfältigungen sind zu löschen, sobald die Analyse sie nicht mehr braucht. Rechteinhaber können die Nutzung vorbehalten, bei online zugänglichen Werken maschinenlesbar. Tragend war, dass das Modell Werke memorisiert hatte und wiedererkennbar ausgeben konnte — die Vervielfältigung endete nicht mit der Analyse.
Wem gehört, was unser KI-Werkzeug ausgibt?
Reiner KI-Output ist in Deutschland meist nicht urheberrechtlich geschützt, weil § 2 Abs. 2 UrhG eine persönliche geistige Schöpfung verlangt. Regeln Sie deshalb vertragliche Nutzungsrechte statt einer Urheberrechtsübertragung, die ins Leere geht. Kein eigener Schutz heißt umgekehrt nicht, dass keine fremden Rechte an der Ausgabe haften — beide Fragen gehören in denselben Vertrag.
Quellen — Stand 12.08.2026
- GEMA zur Suno-Entscheidung — https://www.gema.de/de/w/suno-entscheidung-2026
- LTO zum Urteil des LG München I — https://www.lto.de/recht/hintergruende/h/landgericht-muenchen-i-gema-suno-ki-modell-training-songs-musikkomposition-urheberrechte
- Bird & Bird zur Entscheidung — https://www.twobirds.com/en/insights/2026/germany/munich-district-court-rules-on-ai-generated-music-gema-v-suno
- CMS zu GEMA gegen OpenAI — https://cms.law/de/deu/legal-updates/gema-vs.-openai-urheberrechtliche-grundsatzentscheidung-des-landgerichts-muenchen-i-ergangen
- urheber.info zur eingelegten Berufung — https://urheber.info/diskurs/openai-legt-berufung-ein
Zur Quellenlage: Kammer und Urteilsdatum bestätigt die GEMA-Mitteilung, ein Aktenzeichen nennt sie nicht — nur sekundär belegte Aktenzeichen sind hier deshalb weggelassen.
Dieser Beitrag ist allgemeine Information und keine Rechtsberatung im Einzelfall. Stand 12. August 2026; beide Verfahren sind offen, bitte prüfen Sie vor Entscheidungen den aktuellen Stand.
Leon Lotz
Leon Lotz ist Wirtschaftsjurist und Gründer von MusketierSoftware. Er verbindet juristische Tiefe mit echtem Software-Handwerk.